
(題組 G3:Designing Chips and Systems for Large Language Models,20分。情境:假設我們正在為一間晶片設計公司工作,該公司正嘗試設計LLM加速器,需要取得具代表性的workload並在設計過程中特徵化workload,持續用該workload評估晶片設計以找出效能瓶頸。)
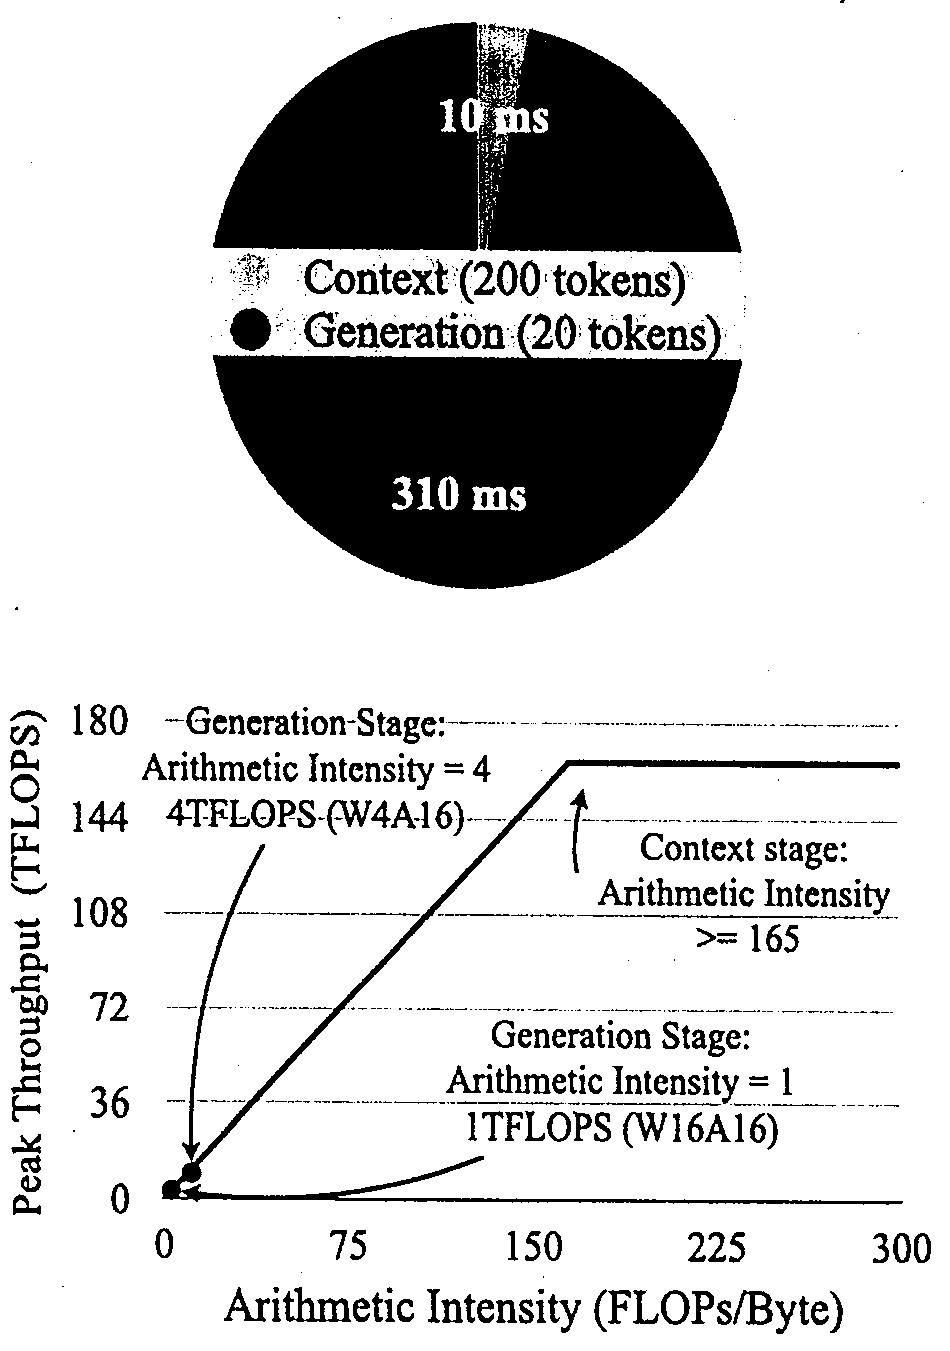
MIT 的一組研究人員開發了一個名為 TinyChat 的 LLM,可在能源受限的邊緣裝置(weak, power-constrained edge devices)上執行。首先,他們在目標應用情境下對 TinyChat 的執行時間做了 profiling,以了解其 workload。這個 LLM workload 被拆分成兩個階段:Context stage 與 Generation Stage,profiling 結果顯示 Generation Stage 主導了執行時間,Generation 占了總執行時間(340ms)中的 310ms。此外,他們使用 arithmetic intensity 與 roofline model 來特徵化這個 workload,下圖回報了這兩個 stages 的 arithmetic intensity:
假設我們正在設計一個處理器晶片,並針對類似的應用微調(fine-tune)這個 LLM,請問下列敘述何者正確?
參考答案與解析
答案 (B)(E)。Generation stage占總執行時間的310/340(絕大部分),其arithmetic intensity只有1~4,遠低於達到compute-bound所需的門檻(圖中顯示context stage要到165以上才算高arithmetic intensity),代表Generation stage明顯是memory-bound,此時增加記憶體頻寬才能真正改善效能,(B)對。圖中W16A16(相當於FP16基準)對應1TFLOPS、W4A16(4-bit權重)對應4TFLOPS,顯示在這個memory-bound區間,throughput大致隨『精度縮減倍數』線性提升;FP16→FP8是位元組減半(2bytes→1byte),依同樣的線性關係推算,加速倍數約為2倍,符合(E)所述。(A)錯:對memory-bound的workload而言,增加運算單元(提高peak throughput)幫不上忙,瓶頸在記憶體而非運算。(C)錯:對memory-bound workload而言,提高clock rate通常無法等比例提升throughput(處理器多數時間在等記憶體),但功耗會上升,throughput-per-watt反而可能變差。(D)錯:LLM推論以稠密矩陣運算為主,控制流簡單、分支少,branch predictor改善對這類workload的效能影響有限,不是這裡的瓶頸。